Intelligent Systems II · TEE · formulas
Unit 4 formulas: Markov chains, MRP, MDP, Bellman
TEE formula sheet · Units 1 and 4
Probability, Bayes, GMM/EM, Markov chains and Bellman equations (Units 2–3 are in the M2 sheet)
Read these symbols in context
P is a transition matrix with origin rows and destination columns. π denotes a stationary distribution in the first equations, but a policy in the MDP equations. s′ is a next state; a′ a next action. R is the specified immediate or expected reward; γ discounts future rewards. E means expectation (probability-weighted average). I is the identity matrix.
The two-state stationary shortcut needs a+b>0. The inverse (I−γP)⁻¹ exists for a finite stochastic P with 0≤γ<1; at γ=1, check the problem’s terminal structure instead of assuming the full matrix is invertible. The continuing discounted-return examples use γ<1. A finite episode can also use γ=1.
Q-learning is supplementary here; the explicitly listed course focus is the Markov/MDP and Bellman material. α in Q-learning is a learning rate; α in Bayes normalisation was a different constant.
Worked explanations: Matrix multiplication · Stationary algebra · Discounted return · Bellman equations.
| Markov property | 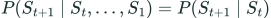 LaTeX: P(S_{t+1}\mid S_t,\dots,S_1)=P(S_{t+1}\mid S_t) |
|---|---|
| Transition matrix | 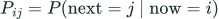 LaTeX: P_{ij}=P(\text{next}=j\mid\text{now}=i); rows sum to 1 |
| Next step |  LaTeX: x_{t+1}=x_tP (row vector);  LaTeX: x_{t+n}=x_tP^n |
| Steady state | 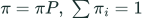 LaTeX: \pi=\pi P,\;\sum\pi_i=1; two states 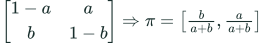 LaTeX: \begin{bmatrix}1-a&a\\b&1-b\end{bmatrix}\Rightarrow\pi=\left[\frac b{a+b},\frac a{a+b}\right] |
| Return | 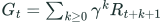 LaTeX: G_t=\sum_{k\ge0}\gamma^kR_{t+k+1} |
| MRP Bellman | 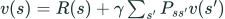 LaTeX: v(s)=R(s)+\gamma\sum_{s'}P_{ss'}v(s'); 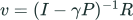 LaTeX: v=(I-\gamma P)^{-1}R |
| Policy | 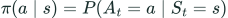 LaTeX: \pi(a\mid s)=P(A_t=a\mid S_t=s) |
| Value functions | 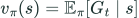 LaTeX: v_\pi(s)=\mathbb E_\pi[G_t\mid s]; 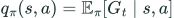 LaTeX: q_\pi(s,a)=\mathbb E_\pi[G_t\mid s,a]; 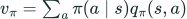 LaTeX: v_\pi=\sum_a\pi(a\mid s)q_\pi(s,a) |
| Bellman expectation | 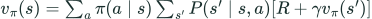 LaTeX: v_\pi(s)=\sum_a\pi(a\mid s)\sum_{s'}P(s'\mid s,a)[R+\gamma v_\pi(s')] |
| Bellman optimality | 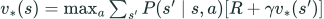 LaTeX: v_*(s)=\max_a\sum_{s'}P(s'\mid s,a)[R+\gamma v_*(s')]; 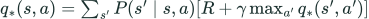 LaTeX: q_*(s,a)=\sum_{s'}P(s'\mid s,a)[R+\gamma\max_{a'}q_*(s',a')] |
Optional further reading: the Q-learning extension is kept with the Bellman lesson, outside this core formula list.